engenheiro de automação de IA × QA / avaliação de LLMN 28.5384° W 81.3789°
Eu entrego recursos de IA. Depois eu provo que funcionam.
Sou quem você chama quando está prestes a lançar um recurso de LLM que pode envergonhar você na frente de um cliente. Eu construo esse recurso — e o gate que o pega no instante em que ele começa a desviar. veja por quê →
Apps de LLM e agentes, além de automação de fluxos de trabalho (RAG, LangGraph, n8n/Make), acompanhados da suíte de regressão e avaliação que os mantém honestos em produção: Playwright, Pytest, k6, Promptfoo, DeepEval, LLM-como-juiz. A maioria constrói a IA ou a testa. Eu faço as duas coisas, e cada afirmação abaixo leva a um artefato.
13/13 gates de prova · vermelho→verde hoje
3,759 testes passando · 91% cobertura de linhas
verificado · reproduzível com um comando
um projeto de cada vez — agenda aberta para o Q4 2026
fig. 01: um recurso falha na avaliação → ele volta. é esse o ponto central.
a versão de 30 segundos
Em uma frase: eu construo o seu recurso de IA — depois provo que ele funciona.
o que eu faço
Avaliação de LLM & RAG, automação de testes & CI, e automação de fluxos de trabalho — o recurso de IA e a evidência de que ele se sustenta.
por que eu
13 anos em qualidade de software na The Home Depot e em fintech. Hoje construo e opero sozinho dois produtos de IA em produção — e este site roda o próprio QA em público.
como começar
Uma Auditoria de Qualidade de IA de uma semana. Você sai com um plano de qualquer forma, e a taxa é abatida do projeto se seguirmos em frente.
Sua operação de hoje, transformada num sistema que você pode provar.
Role a página. O mesmo fluxo de cinco estágios, do manual-e-improvável ao automatizado-e-com-gate-de-avaliação. O formato do que eu construo para você.
construído & operado — não logos de clientes, meus próprios produtos
Dois produtos em produção. Construídos e operados por mim.
A prova mais forte que posso oferecer não é um depoimento — é software que eu entrego e opero sozinho, todo dia. Dois produtos sobre um único sistema de engenharia. Abra a porta da frente de qualquer um deles.
Monorepo-armazém de agentes: agentes de voz, SDR de prospecção, chat de suporte com RAG e orquestradores de fluxo sobre Mastra + LangGraph. Vem com um roteador de LLM multi-provedor, rastreamento de custo por execução e tracing com Langfuse, além de um gate rígido de consentimento TCPA em cada chamada de saída.
página em branco → agente de cliente em ambiente de teste em dias em vez de semanas (estimado a partir do tempo de scaffold do template)
MastraLangGraphVercel AI SDKSupabaseLangfuse
Privado · walkthrough sob solicitação
~/sage-agents
$ pnpm tsx infra/scripts/create-agent.ts \
inbound-voice acme-inbound-voice
@sage/agent-acme-inbound-voice gerado
✓ prompts · tools · evals/golden.json prontos
fig. 02 · arquitetura · saída ao vivo
02
Fluxo de trabalho autônomoVERIFICADO
sage-kernel →
SO de engenharia MCP orientado a provas: 140 ferramentas que um agente de IA conduz por meio de política, aprovações assinadas e um livro-razão de provas encadeado por hash. Nada está “concluído” porque um modelo disse que está. Um firewall de afirmações rejeita linguagem de sucesso não comprovada.
140 ferramentas MCP · 78 gates de release · verificado: suíte de gates + livro-razão de provas encadeado por hash no repositório público
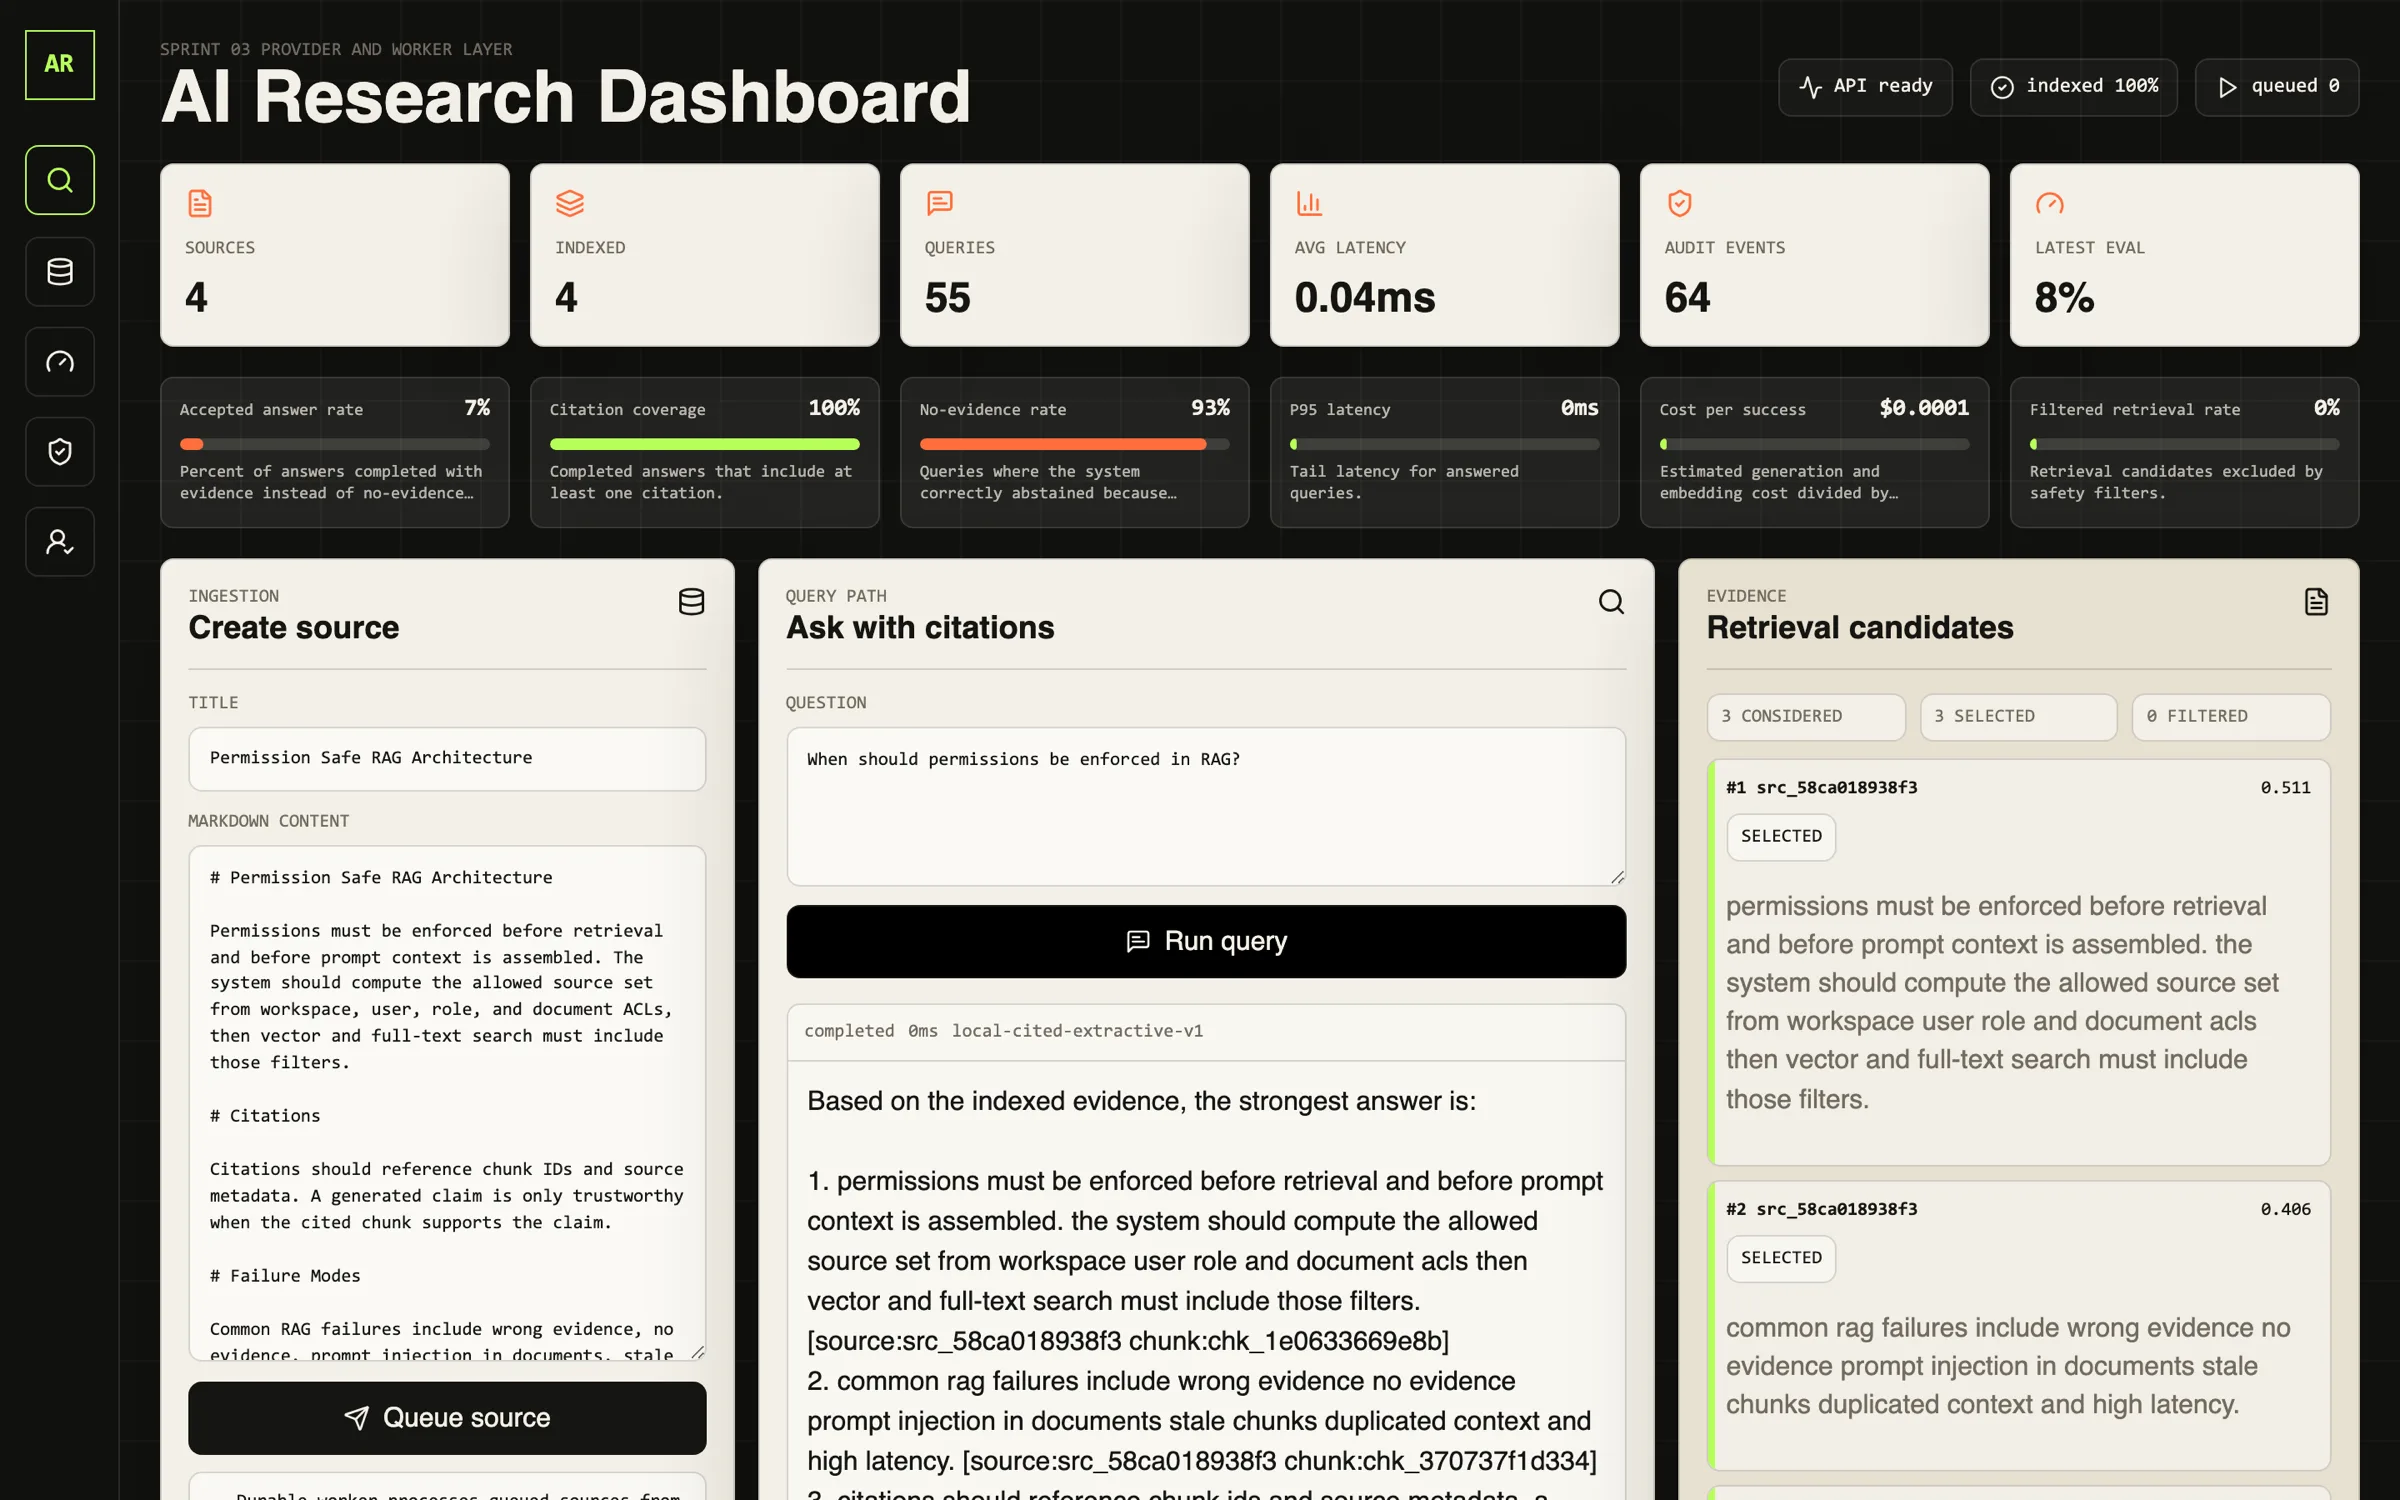
Base de conhecimento RAG em que toda resposta é extrativa e citada. Worker de ingestão durável, recuperação com pgvector, execuções de avaliação persistidas e uma trilha de auditoria completa da fonte à resposta.
100% de cobertura de citações · verificado em 2026-08-15: rodei ao vivo, fiz uma pergunta real, a captura de tela abaixo é a resposta de verdade
Fluxos de e-commerce críticos para o release sob regressão, com a evidência que um release manager pediria: traces, capturas de tela, quatro reporters e um modelo de risco por escrito. O CI envia artefatos a cada push.
37/37 specs · 15,3s · 0 instabilidades · verificado: pasta evidence/ no repositório público, execução datada de 2026-07-10
85 runners de qualidade sob uma única CLI, incluindo avaliações de alucinação, jailbreak, injeção de prompt, toxicidade e vazamento de PII para recursos de LLM. Cada pontuação é calculada a partir de um comando real e empacotada como evidência assinada com ed25519.
3.759 testes · 91% de cobertura · 13/13 · verificado em 2026-08-15: o gate de CVE ficou vermelho às 11:39, bloqueou o release e estava verde às 14:35. Ambas as execuções publicadas.
11:39 ✗ 15 CVEs altos/críticos → NÃO PROVADO 12/13
+9 pisos de segurança · pnpm install
14:35 ✓ 0 altos/críticos → PROVADO 13/13
# pego → bloqueado → corrigido → provado. no mesmo dia.
fig. 06 · arquitetura · saída ao vivo
→
comece aqui · 2 minutos
Receba um plano com escopo e preço para o seu recurso de IA.
Responda 3 perguntas ou converse com a Nadine, minha assistente de IA — você recebe um plano detalhado com uma faixa de preço em cerca de 2 minutos. Sem cadastro, sem ligação de vendas.
✓ Prefere começar pequeno? Comece com uma semana de auditoria a preço fixo de US$ 497 — abatida diretamente no projeto se você continuar.
Como o trabalho realmente aconteceu, em fichas técnicas que você pode auditar.
O resultado primeiro; a especificação completa de oito seções — incluindo as partes que a maioria dos estudos de caso esconde — fica a um clique de distância. Cada número de destaque diz como foi medido.
spec BRIEF/01 · rev A
BRIEF/01
Triagem de feedback que se opera sozinha
fluxo Make + Gemini
Agora o feedback negativo aparece em segundos. Antes ele esperava a revisão de sexta-feira.
Google Forms→Make webhook→Gemini 2.5 Flash · classify + summarize→Sheets log→negativo? → alerta por e-mail
fig. 07 · fluxo do sistema, da esquerda para a direita
Problema
O feedback do cliente chegava por um formulário e ficava sem leitura. Sinais negativos apareciam com dias de atraso, depois que o cliente já tinha ido embora.
Resultados medidos
O feedback negativo aparece em tempo real em vez de na revisão de fim de semana — medido como latência webhook-até-alerta de segundos versus uma passagem manual semanal.
▸ver especificação completa: mais 6 seções
Por que não um chatbot
Ninguém quer conversar com a própria fila de feedback. O valor é determinístico: classificar, resumir, rotear, alertar. Uma interface de chat adicionaria latência e removeria a auditabilidade.
Arquitetura
Cenário no Make, quatro passos de ponta a ponta (ver fig. 1). Cada passo reexecutável isoladamente.
Recuperação / memória
Nenhuma necessária. Cada mensagem é classificada de forma independente. Evitado deliberadamente: a ausência de estado mantém o pipeline depurável.
Pontos de aprovação humana
A IA nunca responde a um cliente. Ela roteia para um humano com um resumo; o e-mail de alerta é o repasse. Ela não resolve nada.
Salvaguardas de produção
Esquema de saída estruturada no passo de LLM, rótulo de fallback em caso de falha de parsing, e a mensagem bruta sempre registrada junto à classificação.
O que eu reforçaria em seguida
Um golden set de mensagens rotuladas rodado toda noite pelo Promptfoo para pegar drift de classificação quando a versão do modelo muda.
stack · Make · Gemini 2.5 Flash · Google Forms · Sheets · Gmail
spec BRIEF/02 · rev A
BRIEF/02
RAG que cita ou fica calado
ai-research-dashboard
100% das respostas citam sua fonte. O pipeline não tem caminho sem citação.
source→chunker→embed → pgvector→cosine retrieval→resposta extrativa + citações→trilha de auditoria
fig. 08 · fluxo do sistema, da esquerda para a direita
Problema
Equipes de pesquisa precisam de respostas do próprio corpus. Um sistema RAG que parafraseia com confiança sem fontes é um passivo, não uma ferramenta.
Resultados medidos
100% das respostas com citação — verificado por design: não existe caminho de geração sem citação. Qualidade, segurança, latência e custo rastreados por consulta no endpoint de analítica.
▸ver especificação completa: mais 6 seções
Por que não um chatbot
Um wrapper de chat sobre o corpus era o build óbvio. A necessidade real era um painel de operações: fontes, jobs de ingestão, execuções de avaliação e feedback, todos inspecionáveis. As perguntas e respostas são um recurso dentro dele.
Arquitetura
API em FastAPI + worker de ingestão durável alimentando a fig. 1; um gateway de provedor troca embeddings determinísticos locais por Gemini conforme o ambiente. Painel em React por cima.
Recuperação / memória
Consultas, respostas e citações persistidas. Apagar uma fonte faz cascata: chunks, embeddings, jobs, payloads, citações. Nenhuma memória órfã.
Pontos de aprovação humana
Um endpoint de feedback em nível de resposta alimenta um loop de revisão; execuções de avaliação são disparadas e persistidas via API para que um humano aprove antes de mudanças de provedor ou de limiar irem ao ar.
Salvaguardas de produção
Respostas apenas extrativas (citar ou abster-se), trilha de auditoria completa sobre eventos de fonte/consulta/avaliação/feedback, provedores locais determinísticos para dev reproduzível, fallback do Gemini para o local quando faltam chaves.
O que eu reforçaria em seguida
Promover os limiares de avaliação a gates de deploy para que uma regressão de recuperação bloqueie o release antes de chegar à retro.
3.759 testes. No dia da publicação o gate pegou um drift real de CVE, me bloqueou, e estava verde de novo à tarde.
qa init · detectar stack→DAG orchestrator→85 runners · incl. 10 avaliações de segurança de LLM→veredito calculado→evidência assinada com ed25519
fig. 09 · fluxo do sistema, da esquerda para a direita
Problema
Painéis de qualidade afirmam números que não conseguem defender. Para recursos de LLM é pior: equipes lançam mudanças de prompt sem nenhum sinal de regressão.
Resultados medidos
3.759 testes, 91,12% de cobertura de linhas, 13/13 gates. Em 2026-08-15 o gate de CVE ficou honestamente vermelho (15 altos/críticos nas dependências) e bloqueou o próprio release — corrigido e PROVADO de novo na mesma tarde, ambas as execuções publicadas na íntegra. Um comando regenera o scorecard.
▸ver especificação completa: mais 6 seções
Por que não um chatbot
Um “assistente de QA com IA” que opina sobre qualidade é exatamente o modo de falha. O veredito precisa ser calculado por código a partir dos códigos de saída dos comandos. Aqui um LLM nunca corrige a própria prova.
Arquitetura
Uma única CLI conduzindo a fig. 1: cada runner é um plugin (detect → plan → run → collectEvidence); um runner travado não consegue emperrar uma execução. Dois gates: pré-commit de <15ms, gate de merge no repositório inteiro.
Recuperação / memória
Livro-razão de evidências em vez de memória: o comando exato de cada execução, o código de saída e a métrica interpretada registrados num livro-razão de provas, reverificável offline.
Pontos de aprovação humana
O loop autônomo de correção é limitado. Ele corrige apenas o que o arcabouço consegue verificar, faz commit quando há melhora, reverte quando há regressão, e para num impasse honesto para revisão humana.
Salvaguardas de produção
Contrato anti-alucinação: nenhuma pontuação sem um artefato de respaldo. Pisos de cobertura crescentes, disciplina de pular honestamente, evidência redigida e assinada com ed25519.
cobertura de avaliação de LLM
Dez runners dedicados à segurança de IA: viés, consistência, alucinação, jailbreak, injeção de prompt, recusa, toxicidade, vazamento de PII, custo, latência. É esse o arcabouço que eu levo aos recursos de LLM dos clientes.
Como distinguir um build de IA de verdade de um revendido.
O mercado se encheu depressa de casas que embrulham um fluxo Zapier alugado em cima de uma margem. Então não acredite só na minha palavra — aqui está o checklist que eu te daria para avaliar qualquer um, inclusive eu. Passe cada linha em mim.
✗ o que a maioria das casas de "automação de IA" faz
✓ o que você recebe aqui
"Agende uma conversa" e uma promessa vaga — nada para inspecionar antes de se comprometer.
Uma demo ao vivo e clicável e comprovantes públicos antes de você falar comigo. Cada número desta página leva à execução literal.
Um fluxo Zapier/Make revendido, idêntico para cada cliente.
Código de verdade no seu repositório, ajustado à sua stack. Você passa a ser dono na entrega — nada preso à minha plataforma.
ROI garantido, orçado antes mesmo de terem visto o seu sistema.
Uma auditoria de preço fixo, de uma semana, que primeiro te diz a verdade — e é abatida direto do projeto se você continuar.
"Estudos de caso" sob NDA e números redondos que você não pode conferir.
Comprovantes que você pode abrir: 37/37 specs verdes no CI, instabilidade de 10%→<1%, 15→0 CVEs — cada um ligado à execução.
Entrega o recurso de IA e torce para que ele se comporte na frente dos seus clientes.
Uma bateria de avaliação + gate de CI — fidelidade, injeção, toxicidade, regressão — para que seja testado antes de tocar um cliente, e não depois.
Você fica preso; eles viram o único ponto de falha.
Runbook, walkthrough, entrega documentada. Sua equipe opera sem mim — e o trabalho sobrevive à minha indisponibilidade.
assista · 45 segundos
Veja a bateria de avaliação bloquear um release — antes que um cliente o fizesse.
Dez verificações, pontuadas por código. Uma falha, o gate impede o embarque. Depois, o arco real de pego-bloqueado-provado do meu próprio repositório.
Escopo fixo, entregáveis fixos, evidência incluída. Cada oferta é uma versão produtizada de algo nos briefings acima.
Contratando em tempo integral? Estas são as três capacidades que eu levaria à sua equipe no primeiro dia, cada uma respaldada por um sistema entregue acima.
QA de recurso de LLM & arcabouço de avaliação
Seu recurso de LLM ganha uma suíte de regressão: golden traces, pontuação LLM-como-juiz para fidelidade e segurança, e um gate de CI que bloqueia o deploy quando a qualidade cai.
→ Suíte Promptfoo / DeepEval sobre seus padrões reais de tráfego
→ Runners de alucinação, injeção & toxicidade
→ Gate de CI + scorecard que seu PM consegue ler
prova: nexural-qa-os · 85 runners incl. 10 avaliações de segurança de IA
Uma suíte Playwright/Pytest com escopo por risco e a disciplina de evidência de um release manager: traces, relatórios, artefatos, integrados ao GitHub Actions desde o primeiro dia.
→ Modelo de risco → matriz de cobertura em vez de sopa de scripts
→ Quatro reporters, trace-on-retry, retenção de artefatos
→ Baseline de carga k6 no caminho crítico
prova: playwright-sdet-regression-suite · 37/37 no CI
Uma automação funcional (entrada, triagem, roteamento, respostas com RAG) construída sobre n8n/Make ou LangGraph, com pontos de aprovação humana onde eles devem estar e logs que você pode auditar.
→ n8n / Make / Zapier ou LangGraph em nível de código
→ Gates com humano no circuito, saídas estruturadas
→ Runbook + entrega para que sua equipe seja dona
prova: templates sage-agents · pipeline de triagem de feedback
Uma melhoria visível, de nível de produção: entregue, medida, no seu repositório.
03 · Build
~4–8 semanas· com escopo & orçamento
O sistema completo: suíte, gate, automação, runbook, sob a posse da sua equipe na entrega.
04 · Operação
contínuo· opcional
Medir, melhorar, publicar: o sistema se acumula em vez de decair em silêncio.
spec OFERTA/01 · preço fixo
OFFER/01
Auditoria de Qualidade de IA
$497
Cerca de uma semana, preço fixo.
Passo o seu recurso de IA em produção por uma bateria de avaliação real — correção, segurança, alucinação, injeção de prompt — e te entrego um relatório pontuado, os transcritos que falharam e uma lista priorizada de correções. Os US$ 2.500 são abatidos direto do projeto se você continuar. O próprio build é orçado a partir do que a auditoria encontra, então você ainda paga pelo seu problema, não por um pacote.
O único entregável padronizado e de preço fixo que eu vendo. Tudo a jusante dele — o build — permanece com escopo e orçamento definidos a partir do que a auditoria revela.
✓Todo projeto é orçado por escrito antes de o trabalho começar: escopo fixo, nunca horas em aberto. A taxa da auditoria é abatida direto do projeto se você continuar. Se o escopo mostrar que não posso ajudar, eu direi, e não custa nada.
um projeto de cada vez — agenda aberta para o Q4 2026
como transcorre um projeto típico de 4 semanas
SEMANA 1
Escopo & mapa de risco
Seu recurso, seus modos de falha. Combinamos o que “funcionar” significa e como será medido.
SEMANA 2–3
Build
A automação, o agente ou a suíte: no seu repositório, seu CI, suas convenções.
SEMANA 3–4
Arcabouço & gate
Avaliações e regressão integradas ao CI. Um gate vermelho bloqueia o deploy antes de ele chegar à retro.
ENTREGA
Runbook & evidência
Docs, scorecard e um walkthrough para que sua equipe seja dona sem mim.
perguntas frequentes
Já temos QA. Por que trazer você?
Sua equipe de QA quase com certeza cobre a superfície determinística. A lacuna é o recurso de LLM: sem golden set, sem juiz, sem gate. Mudanças de prompt vão ao ar no feeling. Eu adiciono a camada de avaliação ao seu pipeline existente; sua equipe passa a ser dona dela quando eu saio.
Você trabalha na nossa stack ou na sua?
Na sua. Seu repositório, seu CI, suas convenções. Todo projeto termina com um runbook e um walkthrough. O entregável é um sistema que sua equipe opera sem mim. Não há dependência de mim.
Quanto custa um projeto?
As necessidades comuns têm preço fixo: uma Auditoria de Qualidade de IA de $497, pacotes a partir de $4.997 e manutenção mensal a partir de $299/mês. A auditoria de entrada e os retainers mensais têm preços definidos; o trabalho de projeto é orçado por escrito após uma breve conversa de escopo — escopo fixo, nunca horas em aberto. A conversa inicial de 15 minutos é gratuita e termina com um plano concreto e um número real de qualquer forma. Comece pela auditoria e o orçamento do build maior já vem embutido.
Com que rapidez você pode começar?
Agendo um projeto de cada vez (veja o selo de disponibilidade no topo da página). A semana 1 é de escopo, então o risco de calendário é baixo: você saberá exatamente o que terá antes de o build começar.
Qual é o prazo típico?
A auditoria leva uma semana. Sprints do tamanho de piloto duram 2–3 semanas; builds completos, de 4 a 8 dependendo do escopo. Todo projeto entrega algo visível dentro das duas primeiras semanas. Sem longas fases silenciosas.
Como você lida com nossos dados e código?
Aberto a NDA. O acesso é restrito ao projeto, as credenciais permanecem nos seus sistemas, o código permanece nos seus repositórios, e nada é retido após a entrega. O one-pager de tratamento de dados está disponível antes de começarmos.
Não poderíamos simplesmente construir isso internamente?
Muitas vezes você deveria — e na entrega você estará fazendo isso. A diferença é o papel: uma contratação interna mantém o sistema no dia a dia; eu sou trazido para projetá-lo uma vez, com o padrão de muitos desses builds já embutido — a bateria de avaliação, os modos de falha, o gate. As horas de build são a parte barata. O custo real de fazer internamente é o contínuo: manter as avaliações honestas, perseguir o drift de modelo e de API, e a regressão que ninguém pega até um cliente pegar. Eu monto isso para que se sustente, e depois entrego as chaves à sua equipe.
Após a entrega — e se quebrar, e se você não estiver por perto?
Tudo fica no seu repositório e CI, com um runbook e um walkthrough — sem dependência de mim, nada preso à minha plataforma. Se algo desviar, o gate é construído para pegá-lo antes de ir ao ar e o runbook diz exatamente o que fazer. Acesso, credenciais e um plano de entrega por escrito existem desde o primeiro dia, para que o trabalho sobreviva à minha indisponibilidade. A janela opcional de operação está lá se você quiser uma mão, não porque você vai precisar.
E se as avaliações mostrarem que nosso recurso de IA está bem?
Então você vai ao ar com evidência em vez de esperança. Essa é a vitória. A suíte permanece no CI pegando a regressão que teria surgido daqui a seis semanas.
Vagas em tempo integral?
Aberto à vaga certa. O botão “Contrate-me” no topo reformula esta página para recrutadores, e o PDF do currículo está a um clique.
05
05 — sobre
JTJason Teixeira
Por treze anos meu trabalho foi garantir que o software realmente funcionasse. O tipo de QA em que um bug que passa custa dinheiro de verdade. Então os recursos de IA começaram a ser lançados com uma demo e uma reza, e eu vi bons produtos quebrarem de formas que um cliente descobria primeiro. Então agora eu construo as duas metades: a IA, e a prova de que funciona.
— Jason Teixeira · fundador, Sage Ideas
Eu comando a Sage Ideas, um estúdio AI-native, e passei anos construindo a mesma coisa em cada camada: sistemas que se recusam a dizer “concluído” sem evidência.
Essa tese aparece como um SO de engenharia com um livro-razão de provas encadeado por hash, uma plataforma de QA em que cada pontuação é calculada a partir de um comando real, e pipelines de agentes com avaliações de golden trace integradas ao CI. O padrão é sempre o mesmo: entregar o recurso, e depois entregar a maquinaria que o pega quando ele regride.
Se a sua equipe está lançando recursos de LLM no feeling (sem suíte de avaliação, sem gate de regressão, sem ideia se a mudança de prompt da semana passada piorou as coisas), essa é exatamente a lacuna que eu fecho.
Eu construo
LangGraph · Mastra agents
RAG — pgvector · citações
fluxos n8n · Make · Zapier
Next.js · FastAPI · Supabase
agentes de voz — Retell · Vapi
JTum engenheiro
Eu provo
Playwright · Pytest · k6
Promptfoo · DeepEval
LLM-como-juiz — fidelidade
avaliações de jailbreak · injeção · PII
gates de CI · evidência assinada
capacidade
construtor de IA típico
engenheiro de QA típico
eu
Entrega recursos de LLM (RAG, agentes, automação)
✓
—
✓
Constrói suítes de avaliação & gates LLM-como-juiz
raro
raro
✓ entregue
Disciplina de regressão no CI (Playwright/Pytest)
—
✓
✓ 13 anos
Bateria de segurança de IA (injeção · PII · toxicidade)
—
—
✓ 10 runners
Evidência que você pode auditar (assinada, reproduzível)
—
raro
✓ por design
Certificado para isso (ISTQB CT-AI + TAE)
—
raro
✓ ambos
06
06 — histórico
Rigor de Fortune 50, velocidade de fundador.
Treze anos entre varejo corporativo e fintech, mais um estúdio AI-native. Cada cargo na mesma disciplina: automação que prova que o software funciona. Os números de cargos anteriores são autodeclarados. Currículo completo (PDF) ↓ · Visão geral da empresa · Veja a prova →
Sage Ideas · Nexural
Fundador, Engenheiro de Automação de IA & QA2024 — presente · Orlando, FL / remoto
Construí tudo no índice acima: o armazém de agentes, o SO de engenharia orientado a provas e uma plataforma de QA de 85 runners com dez avaliações dedicadas à segurança de LLM.
Nexural Research: 58 endpoints FastAPI · 604 testes · 93% de cobertura, validação de respostas de IA que confronta as afirmações do modelo com métricas determinísticas da fonte.
Infraestrutura de testes baseada em Kubernetes rodando 500+ testes contra fluxos de trading ao vivo (volume diário de US$ 100 mil+); taxa de instabilidade reduzida de 10% → <1% com retry inteligente.
Execução de testes de 45 min → 8 min (−82%) via conteinerização com Docker e execuções paralelas entre microsserviços.
execução de testes45m → 8m
The Home Depot
Testador de Software → Engenheiro de Automação → Engenheiro de Nuvem2012 — 2021 · Fortune 50
Framework Selenium + Python para sistemas que atendem 2.300+ lojas: regressão de 4 h → 75 min (−70%), 300+ casos automatizados com 99,5% de estabilidade.
Liderei a migração corporativa para AWS (Terraform, Kubernetes): −35% de custo de infraestrutura, deploys de 4 h → 15 min via pipelines Jenkins/GitLab.
regressão4h → 75m
deploys4h → 15m
credenciais
ISTQB CT-AI — testes de IAISTQB Test Automation EngineerISTQB CTFLAWS Cloud PractitionerAWS ML FoundationsTripleTen AI Automation
Bacharel em Ciência da Computação, Full Sail · Bacharel em Finanças, Kean · Inglês + Português nativos · Espanhol profissional
07 — em números
13+
anos em qualidade & automação
140
repositórios públicos no GitHub
85
runners de qualidade construídos
78
gates de release, todos verdes
08
08 — notas de campo
Anotações de trabalho das trincheiras orientadas a provas.
15 minutos. Traga o recurso que te assusta. Saia com um plano concreto de avaliação e automação.
Uma contratação, duas disciplinas.
O engenheiro que entrega o recurso de LLM e o arcabouço que o protege. Vamos conversar sobre a sua equipe.
escolha um horário — 15 min, grátis·Eu conduzo a conversa e respondo pessoalmente. Sem equipe de vendas, sem spam — uma confirmação instantânea, depois uma resposta real minha.
✓Todo projeto é orçado por escrito antes de o trabalho começar: escopo fixo, nunca horas em aberto. A taxa da auditoria é abatida direto do projeto se você continuar. Se o escopo mostrar que não posso ajudar, eu direi, e não custa nada.
um projeto de cada vez — agenda aberta para o Q4 2026
mini-avaliação grátis · uma amostra de trabalho que fica com você
Envie-me o seu recurso de IA. Vou rodar uma mini-avaliação grátis nele e te enviar as conclusões: passa/falha, exemplos de falha, e o que eu colocaria num gate antes do seu próximo release. Sem necessidade de conversa.
1 — conversa inicial
15 minutos, grátis. Traga o recurso que te assusta.
2 — mapa de risco
Semana 1: combinamos o que “funcionar” significa e como é medido.
3 — orçamento fixo
Preço atrelado a entregáveis em vez de horas em aberto. De qualquer forma, o plano é seu.