ingeniero de automatización con IA × QA / eval de LLMN 28.5384° W 81.3789°
Yo construyo funciones de IA. Después pruebo que funcionan.
Soy a quien llamas cuando estás a punto de lanzar una función de LLM que podría dejarte en ridículo frente a un cliente. La construyo, junto con la compuerta que la detecta en cuanto se desvía. mira por qué →
Aplicaciones y agentes de LLM, más automatización de flujos de trabajo (RAG, LangGraph, n8n/Make), junto con el arnés de regresión y evaluación que los mantiene honestos en producción: Playwright, Pytest, k6, Promptfoo, DeepEval, LLM-as-judge. La mayoría construye la IA o la prueba. Yo hago ambas, y cada afirmación de abajo enlaza a un artefacto.
13/13 compuertas de prueba · de rojo→verde hoy
3,759 pruebas pasando · 91% cobertura de líneas
verificado · reproducible con un solo comando
un proyecto a la vez — actualmente agendando Q4 2026
fig. 01: una función falla la evaluación → regresa. ese es todo el punto.
la versión de 30 segundos
En una frase: construyo tu función de IA — y luego pruebo que funciona.
qué hago
Evaluación de LLM & RAG, automatización de pruebas & CI, y automatización de flujos de trabajo — la función de IA y la evidencia de que se sostiene.
por qué yo
13 años en calidad de software en The Home Depot y en fintech. Hoy construyo y opero dos productos de IA en vivo yo solo — y este sitio ejecuta su propio QA en público.
cómo empezar
Una Auditoría de Calidad de IA de una semana. Se va con un plan en cualquier caso, y la tarifa se abona al build si continuamos.
▸ 141 pruebas unitarias, la propia compuerta de QA de 128 verificaciones del sitio, y una evaluación de LLM — comandos reales, números reales, con mi voz.
Tu operación de hoy, convertida en un sistema que puedes probar.
Deslízalo. El mismo flujo de cinco etapas, de manual-e-improbable a automatizado-y-con-compuerta-de-evaluación. La forma de lo que construyo para ti.
construido & operado — no logos de clientes, mis propios productos
Dos productos en vivo. Construidos y operados por mí mismo.
La prueba más fuerte que puedo ofrecer no es un testimonio — es software que lanzo y opero yo solo, todos los días. Dos productos sobre un mismo sistema de ingeniería. Abre la puerta principal de cualquiera.
Monorepo de almacén de agentes: agentes de voz, SDR saliente, chat de soporte con RAG y orquestadores de flujos sobre Mastra + LangGraph. Incluye un router de LLM multi-proveedor, rastreo de costo por ejecución y trazado con Langfuse, además de una compuerta estricta de consentimiento TCPA en cada llamada saliente.
página en blanco → agente de cliente montado en días en vez de semanas (estimado a partir del tiempo de andamiaje de plantillas)
MastraLangGraphVercel AI SDKSupabaseLangfuse
Privado · guía a petición
~/sage-agents
$ pnpm tsx infra/scripts/create-agent.ts \
inbound-voice acme-inbound-voice
scaffolded @sage/agent-acme-inbound-voice
✓ prompts · tools · evals/golden.json ready
fig. 02 · arquitectura · salida en vivo
02
Flujo de trabajo autónomoVERIFICADO
sage-kernel →
SO de ingeniería MCP proof-first: 140 herramientas que un agente de IA opera a través de política, aprobaciones firmadas y un libro de pruebas encadenado por hash. Nada está "listo" porque un modelo lo haya dicho. Un cortafuegos de afirmaciones rechaza el lenguaje de éxito no probado.
140 herramientas MCP · 78 compuertas de release · verificado: suite de compuertas + libro de pruebas encadenado por hash en el repo público
Base de conocimiento RAG donde cada respuesta es extractiva y citada. Worker de ingesta durable, recuperación con pgvector, ejecuciones de evaluación persistidas y una traza de auditoría completa de la fuente a la respuesta.
100% de cobertura de citas · verificado 2026-08-15: lo ejecuté en vivo, hice una pregunta real, la captura de abajo es la respuesta real
Flujos de e-commerce críticos para el release bajo regresión con la evidencia que pediría un release manager: trazas, capturas, cuatro reporters y un modelo de riesgo por escrito. CI sube artefactos en cada push.
37/37 specs · 15.3s · 0 flaky · verificado: carpeta evidence/ en el repo público, ejecución fechada 2026-07-10
85 runners de calidad bajo un solo CLI, incluyendo evaluaciones de alucinación, jailbreak, inyección de prompts, toxicidad y fuga de PII para funciones de LLM. Cada puntaje se calcula a partir de un comando real y se empaqueta como evidencia firmada con ed25519.
3,759 pruebas · 91% cobertura · 13/13 · verificado 2026-08-15: la compuerta de CVE se puso roja a las 11:39, bloqueó el release, y estaba verde para las 14:35. Ambas ejecuciones publicadas.
# atrapado → bloqueado → parcheado → probado. el mismo día.
fig. 06 · arquitectura · salida en vivo
→
empieza aquí · 2 minutos
Consigue un plan con alcance y precio para tu función de IA.
Responde 3 preguntas o habla con Nadine, mi asociada de IA — recibirás un plan detallado con un rango de precio en unos 2 minutos. Sin registro, sin llamada de ventas.
✓ ¿Prefieres empezar con algo pequeño? Empieza con una auditoría de una semana a precio fijo de $497 USD — se abona directamente al build si continúas.
Cómo transcurrió el trabajo en realidad, como fichas técnicas que puedes auditar.
Primero el resultado; la spec completa de ocho secciones — incluidas las partes que la mayoría de los casos de estudio ocultan — está a un clic de distancia. Cada número destacado indica cómo se midió.
spec BRIEF/01 · rev A
BRIEF/01
Triage de feedback que se ejecuta solo
flujo Make + Gemini
El feedback negativo ahora aparece en segundos. Antes esperaba a la revisión del viernes.
Google Forms→Make webhook→Gemini 2.5 Flash · clasificar + resumir→registro en Sheets→¿negativo? → alerta por correo
fig. 07 · flujo del sistema, de izquierda a derecha
Problema
El feedback de los clientes llegaba por un formulario y quedaba sin leer. Las señales negativas aparecían días tarde, cuando el cliente ya se había ido.
Resultados medidos
El feedback negativo aparece en tiempo real en lugar de en la revisión de fin de semana — medido como latencia de webhook a alerta de segundos frente a un repaso manual semanal.
▸ver spec completa: 6 secciones más
Por qué no un chatbot
Nadie quiere conversar con su propia cola de feedback. El valor es determinista: clasificar, resumir, enrutar, alertar. Una interfaz de chat agregaría latencia y quitaría auditabilidad.
Arquitectura
Escenario de Make, cuatro pasos de principio a fin (ver fig. 1). Cada paso re-ejecutable de forma aislada.
Recuperación / memoria
No hace falta. Cada mensaje se clasifica de forma independiente. Evitado deliberadamente: la ausencia de estado mantiene el pipeline depurable.
Puntos de aprobación humana
La IA nunca responde a un cliente. Enruta a un humano con un resumen; el correo de alerta es la entrega. No resuelve nada.
Salvaguardas de producción
Esquema de salida estructurada en el paso del LLM, etiqueta de respaldo ante fallo de parseo, y el mensaje crudo siempre registrado junto a la clasificación.
Qué reforzaría a continuación
Un conjunto dorado de mensajes etiquetados ejecutado cada noche con Promptfoo para atrapar el desvío de clasificación cuando cambia la versión del modelo.
stack · Make · Gemini 2.5 Flash · Google Forms · Sheets · Gmail
spec BRIEF/02 · rev A
BRIEF/02
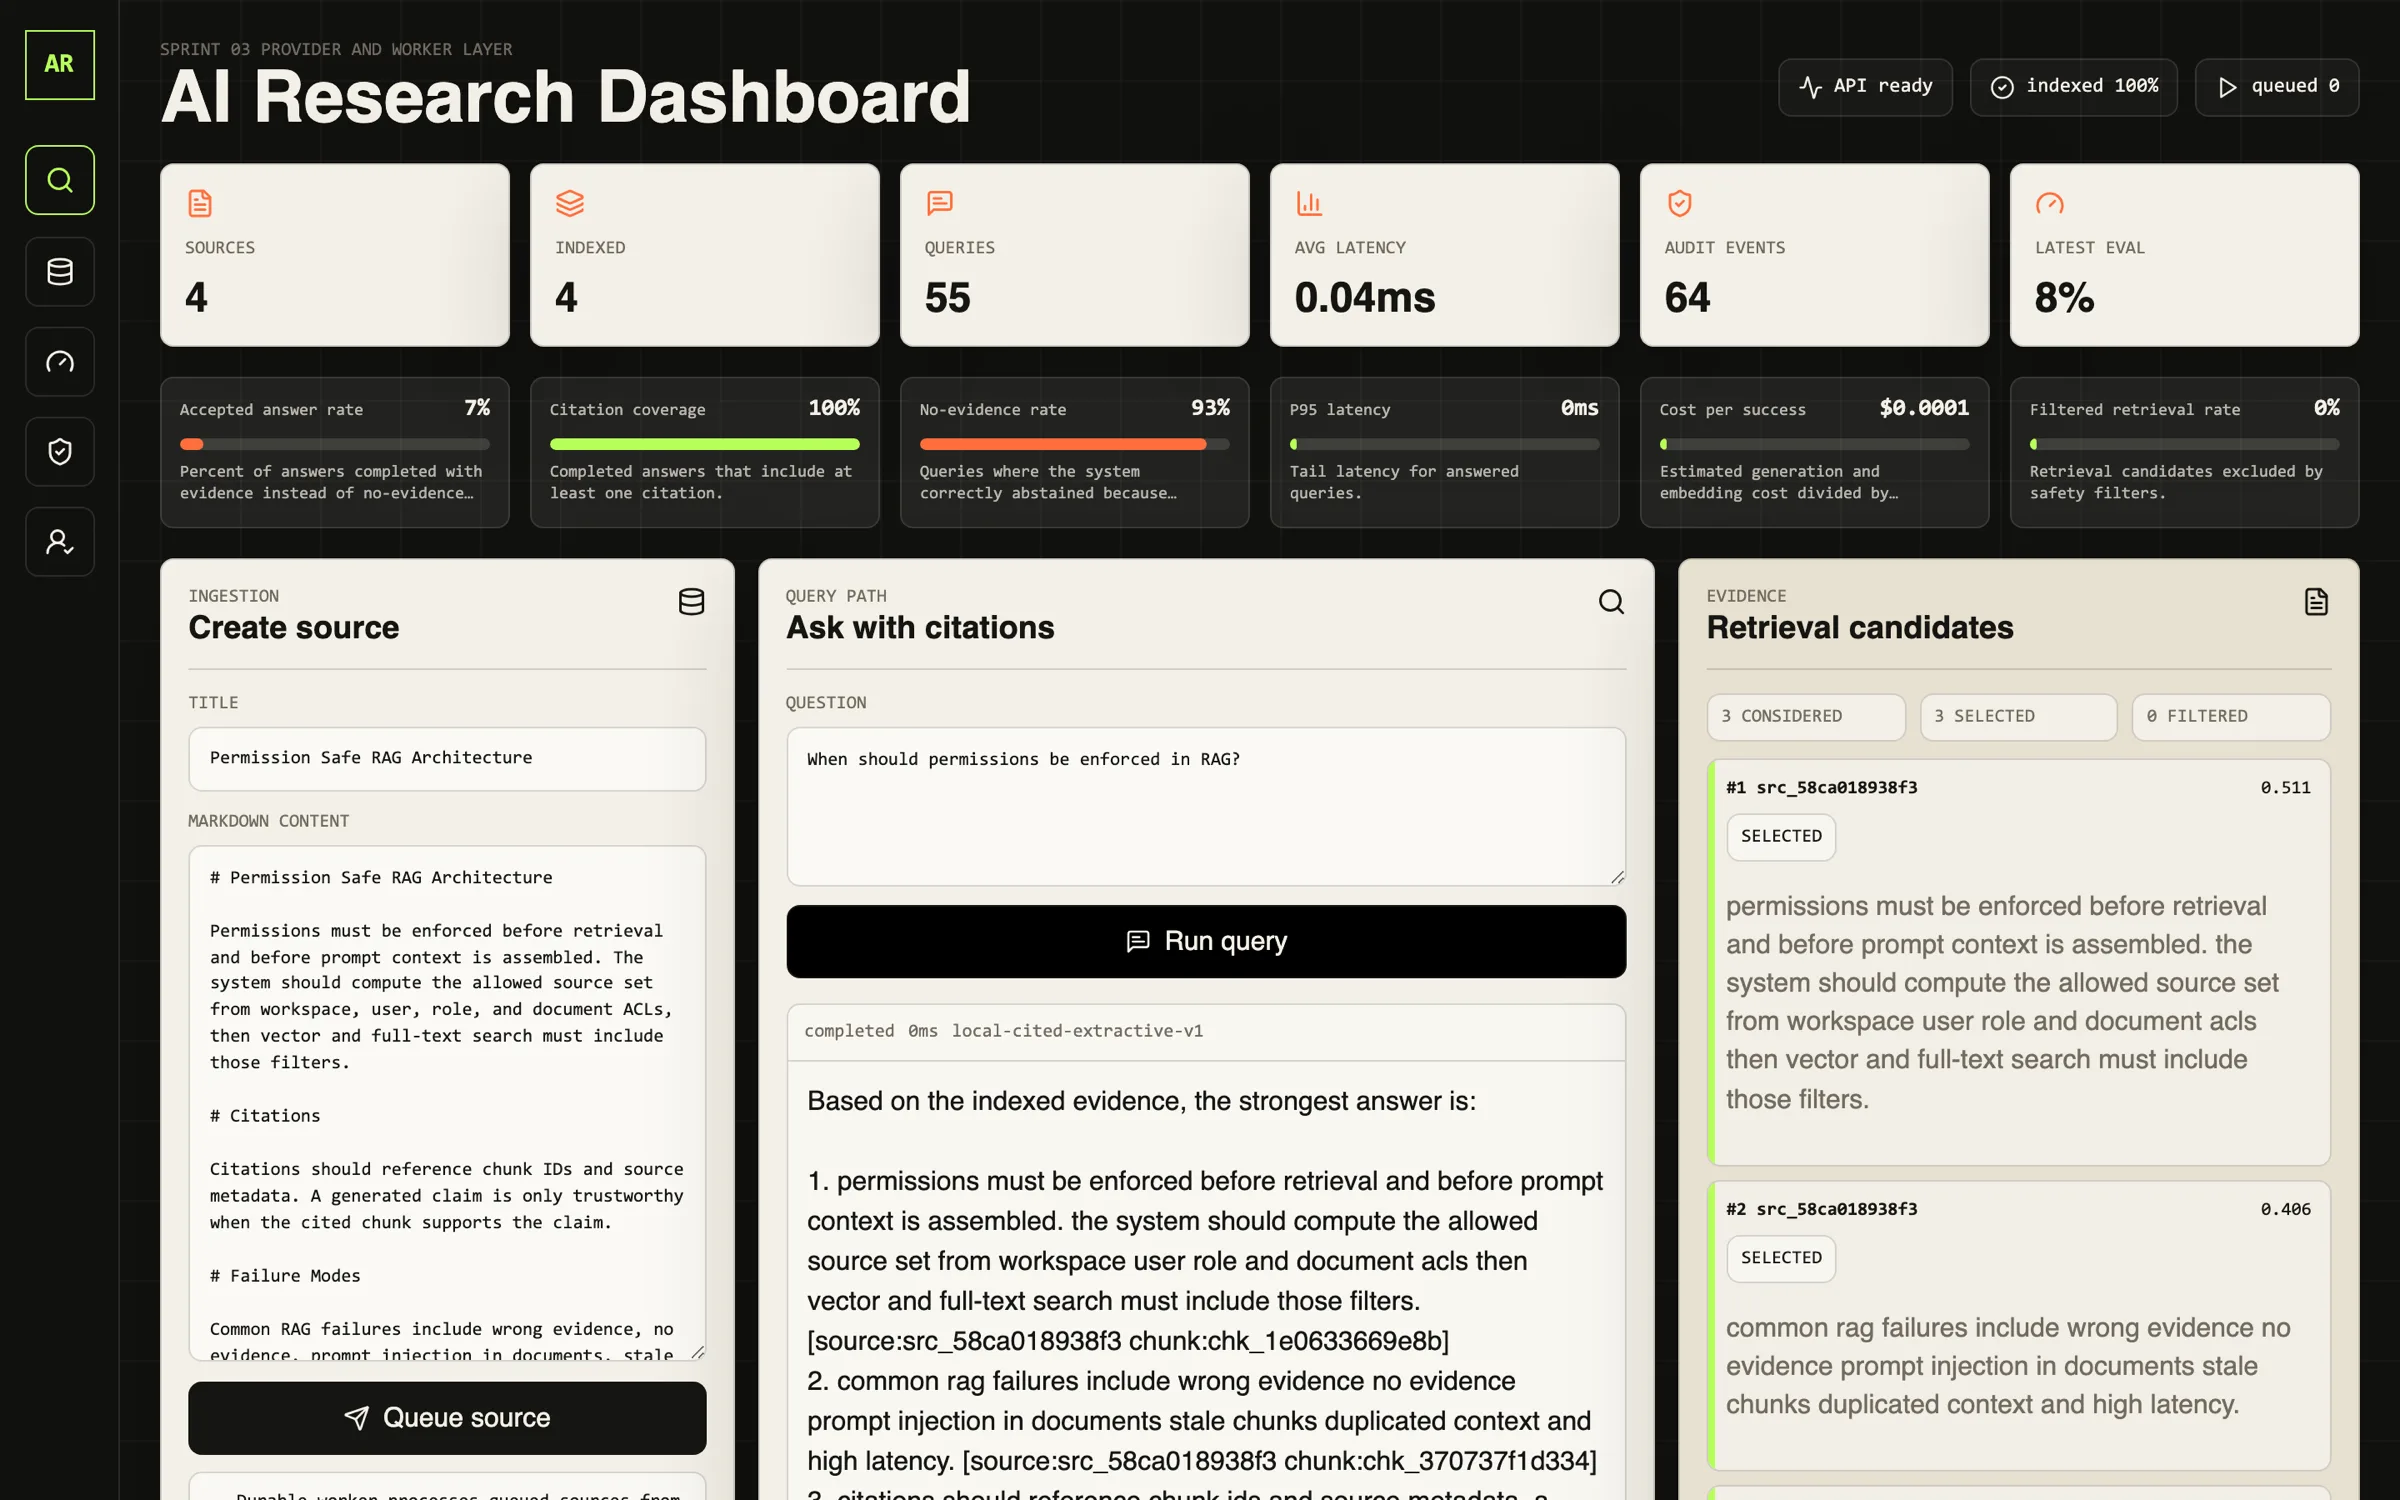
RAG que cita o se calla
ai-research-dashboard
El 100% de las respuestas citan su fuente. El pipeline no tiene ninguna ruta sin cita.
fuente→chunker→embed → pgvector→recuperación por coseno→respuesta extractiva + citas→traza de auditoría
fig. 08 · flujo del sistema, de izquierda a derecha
Problema
Los equipos de investigación necesitan respuestas de su propio corpus. Un sistema RAG que parafrasea con confianza sin fuentes es un pasivo en lugar de una herramienta.
Resultados medidos
100% de las respuestas respaldadas por citas — verificado por diseño: no existe ninguna ruta de generación sin cita. Calidad, seguridad, latencia y costo rastreados por consulta en el endpoint de analítica.
▸ver spec completa: 6 secciones más
Por qué no un chatbot
Un envoltorio de chat sobre el corpus era el build obvio. La necesidad real era un dashboard de operaciones: fuentes, trabajos de ingesta, ejecuciones de evaluación y feedback, todo inspeccionable. El preguntas y respuestas es una función dentro de él.
Arquitectura
API FastAPI + worker de ingesta durable que alimenta la fig. 1; el gateway de proveedores intercambia embeddings deterministas locales por Gemini según el entorno. Dashboard en React encima.
Recuperación / memoria
Consultas, respuestas y citas persistidas. Eliminar una fuente cae en cascada: fragmentos, embeddings, trabajos, payloads, citas. Sin memoria huérfana.
Puntos de aprobación humana
El endpoint de feedback a nivel de respuesta alimenta un ciclo de revisión; las ejecuciones de evaluación se disparan y persisten por API para que un humano dé el visto bueno antes de lanzar cambios de proveedor o de umbral.
Salvaguardas de producción
Respuestas solo extractivas (citar o abstenerse), traza de auditoría completa en eventos de fuente/consulta/evaluación/feedback, proveedores locales deterministas para dev reproducible, respaldo de Gemini a local cuando faltan claves.
Qué reforzaría a continuación
Promover los umbrales de evaluación a compuertas de despliegue para que una regresión de recuperación bloquee el release antes de que llegue a la retro.
3,759 pruebas. El día de publicación la compuerta atrapó un desvío real de CVE, me bloqueó, y estaba verde de nuevo por la tarde.
qa init · detectar stack→DAG orchestrator→85 runners · incl. 10 evals de seguridad LLM→veredicto calculado→evidencia firmada con ed25519
fig. 09 · flujo del sistema, de izquierda a derecha
Problema
Los dashboards de calidad afirman números que no pueden defender. Para las funciones de LLM es peor: los equipos lanzan cambios de prompt sin ninguna señal de regresión.
Resultados medidos
3,759 pruebas, 91.12% de cobertura de líneas, 13/13 compuertas. El 2026-08-15 la compuerta de CVE se puso honestamente roja (15 altas/críticas en dependencias) y bloqueó su propio release — parcheado y PROBADO de nuevo esa misma tarde, ambas ejecuciones publicadas literalmente. Un comando regenera el scorecard.
▸ver spec completa: 6 secciones más
Por qué no un chatbot
Un "asistente de QA con IA" que opina sobre la calidad es exactamente el modo de falla. El veredicto debe calcularlo el código a partir de los códigos de salida de los comandos. Aquí un LLM nunca califica su propia tarea.
Arquitectura
Un CLI que impulsa la fig. 1: cada runner es un plugin (detect → plan → run → collectEvidence); un runner colgado no puede estancar una ejecución. Dos compuertas: pre-commit de <15ms, compuerta de merge de repo completo.
Recuperación / memoria
Libro de evidencia en lugar de memoria: el comando exacto, el código de salida y la métrica parseada de cada ejecución quedan registrados en un libro de pruebas, re-verificable sin conexión.
Puntos de aprobación humana
El ciclo autónomo de corrección está acotado. Solo corrige lo que el arnés puede verificar, hace commit al mejorar, revierte ante una regresión, y se detiene en un estancamiento honesto para revisión humana.
Salvaguardas de producción
Contrato anti-alucinación: sin puntaje sin un artefacto de respaldo. Pisos de cobertura crecientes, disciplina de omisión honesta, evidencia redactada firmada con ed25519.
Cobertura de evaluación de LLM
Diez runners dedicados a la seguridad de IA: sesgo, consistencia, alucinación, jailbreak, inyección de prompts, rechazo, toxicidad, fuga de PII, costo, latencia. Ese es el arnés que aporto a las funciones de LLM de los clientes.
Cómo distinguir un build de IA real de uno revendido.
El mercado se llenó rápido de tiendas que envuelven un flujo de Zapier alquilado con un sobreprecio. Así que no me creas a mí — aquí está la checklist que te entregaría para evaluar a cualquiera, yo incluido. Aplica cada línea sobre mí.
✗ lo que hacen la mayoría de las tiendas de "automatización con IA"
✓ lo que obtienes aquí
"Agenda una llamada" y una promesa vaga — nada que inspeccionar antes de comprometerte.
Un demo en vivo y clicable y recibos públicos antes de siquiera hablar conmigo. Cada número de esta página enlaza a la ejecución literal.
Un flujo Zapier/Make revendido que se ve idéntico para cada cliente.
Código real en tu repositorio, ajustado a tu stack. Es tuyo en la entrega — nada atado a mi plataforma.
ROI garantizado, cotizado antes de siquiera haber visto tu sistema.
Una auditoría de precio fijo y una semana que te dice la verdad primero — y se abona directamente al build si continúas.
"Casos de estudio" bajo NDA y números redondos que no puedes verificar.
Recibos que puedes abrir: 37/37 specs en verde en CI, 10%→<1% flaky, 15→0 CVEs — cada uno enlazado a la ejecución.
Lanza la función de IA y espera que se comporte frente a tus clientes.
Una batería de evaluación + compuerta de CI — fidelidad, inyección, toxicidad, regresión — para que esté probada antes de tocar a un cliente, no después.
Quedas atrapado; ellos se vuelven el único punto de falla.
Runbook, guía, entrega documentada. Tu equipo lo opera sin mí — y el trabajo sobrevive a que yo no esté disponible.
mira · 45 segundos
Mira la batería de evaluación bloquear un release — antes de que lo haga un cliente.
Diez verificaciones, puntuadas por código. Una falla, la compuerta detiene el lanzamiento. Luego el arco real de atrapado-bloqueado-probado desde mi propio repo.
Alcance fijo, entregables fijos, evidencia incluida. Cada oferta es una versión productizada de algo en los briefs de arriba.
¿Contratando de tiempo completo? Estas son las tres capacidades que aportaría a tu equipo desde el día uno, cada una respaldada por un sistema lanzado arriba.
QA de funciones LLM & arnés de evaluación
Tu función de LLM obtiene una suite de regresión: trazas doradas, puntuación con LLM-as-judge para fidelidad y seguridad, y una compuerta de CI que bloquea el deploy cuando cae la calidad.
→ Suite Promptfoo / DeepEval sobre tus patrones de tráfico reales
→ Runners de alucinación, inyección & toxicidad
→ Compuerta de CI + scorecard que tu PM puede leer
prueba: nexural-qa-os · 85 runners incl. 10 evals de seguridad IA
Una suite Playwright/Pytest con alcance por riesgo y la disciplina de evidencia de un release manager: trazas, reportes, artefactos, conectados a GitHub Actions desde el día uno.
→ Modelo de riesgo → matriz de cobertura en vez de sopa de scripts
→ Cuatro reporters, trace-on-retry, retención de artefactos
→ Línea base de carga con k6 en la ruta crítica
prueba: playwright-sdet-regression-suite · 37/37 en CI
Build de automatización de flujos de trabajo con IA
Una automatización funcional (ingesta, triage, enrutamiento, respuestas respaldadas por RAG) construida sobre n8n/Make o LangGraph, con puntos de aprobación humana donde corresponden y logs que puedes auditar.
→ n8n / Make / Zapier o LangGraph a nivel de código
→ Compuertas con humano en el circuito, salidas estructuradas
→ Runbook + entrega para que tu equipo sea el dueño
prueba: plantillas sage-agents · pipeline de triage de feedback
Una mejora visible de nivel de producción: lanzada, medida, en tu repositorio.
03 · Build
~4–8 semanas· definido & cotizado
El sistema completo: suite, compuerta, automatización, runbook, propiedad de tu equipo en la entrega.
04 · Operación
continuo· opcional
Medir, mejorar, publicar: el sistema se capitaliza en lugar de decaer en silencio.
spec OFERTA/01 · precio fijo
OFFER/01
Auditoría de Calidad de IA
$497
Cerca de una semana, precio fijo.
Ejecuto tu función de IA en vivo a través de una batería de evaluación real — corrección, seguridad, alucinación, inyección de prompts — y te entrego un reporte con puntaje, las transcripciones que fallan y una lista priorizada de correcciones. Los $497 se abonan directamente al build si continúas. El build en sí se cotiza según lo que encuentre la auditoría, así que sigues pagando por tu problema, no por un paquete.
El único entregable estandarizado y de precio fijo que vendo. Todo lo que viene después — el build — se mantiene definido y cotizado según lo que revele la auditoría.
✓Cada proyecto se cotiza por escrito antes de empezar: alcance fijo, nunca horas abiertas. La tarifa de la auditoría se abona directamente al build si continúas. Si la definición de alcance muestra que no puedo ayudar, lo diré y no cuesta nada.
un proyecto a la vez — actualmente agendando Q4 2026
cómo transcurre un proyecto típico de 4 semanas
SEMANA 1
Alcance & mapa de riesgos
Tu función, tus modos de falla. Acordamos qué significa "que funcione" y cómo se medirá.
SEMANA 2–3
Build
La automatización, el agente o la suite: en tu repositorio, tu CI, tus convenciones.
SEMANA 3–4
Arnés & compuerta
Evaluaciones y regresión conectadas a CI. Una compuerta roja bloquea el deploy antes de que llegue a la retro.
ENTREGA
Runbook & evidencia
Documentación, scorecard y una guía para que tu equipo sea el dueño sin mí.
preguntas frecuentes
Ya tenemos QA. ¿Por qué traerlo?
Es casi seguro que tu equipo de QA cubre la superficie determinista. La brecha es la función de LLM: sin conjunto dorado, sin juez, sin compuerta. Los cambios de prompt se lanzan por intuición. Yo agrego la capa de evaluación a tu pipeline existente; tu equipo la mantiene cuando me voy.
¿Trabajas en nuestro stack o en el tuyo?
En el tuyo. Tu repositorio, tu CI, tus convenciones. Cada proyecto termina con un runbook y una guía. El entregable es un sistema que tu equipo opera sin mí. No hay dependencia de mí.
¿Cuánto cuesta un proyecto?
Los casos comunes tienen precio fijo: una Auditoría de Calidad de IA de $497, paquetes desde $4,997 y mantenimiento mensual desde $299/mes. La auditoría de entrada y los retainers mensuales tienen precios fijos; el trabajo de proyecto se cotiza por escrito tras una breve llamada de definición de alcance — alcance fijo, nunca horas abiertas. La llamada de introducción de 15 minutos es gratis y termina con un plan concreto y un número real en cualquier caso. Empieza con la auditoría y obtienes incluida la cotización del build más grande.
¿Qué tan rápido puedes empezar?
Agendo un proyecto a la vez (mira el chip de disponibilidad en la parte superior de la página). La semana 1 es de definición de alcance, así que el riesgo de calendario es bajo: sabrás exactamente qué obtendrás antes de que comience el build.
¿Cuál es el plazo típico?
La auditoría dura una semana. Los sprints tipo piloto duran de 2 a 3 semanas; los builds completos de 4 a 8 según el alcance. Cada proyecto lanza algo visible dentro de las primeras dos semanas. Sin fases largas de silencio.
¿Cómo manejas nuestros datos y código?
Compatible con NDA. El acceso se limita al proyecto, las credenciales permanecen en tus sistemas, el código permanece en tus repositorios, y nada se retiene después de la entrega. La ficha de manejo de datos está disponible antes de empezar.
¿No podríamos construir esto internamente?
A menudo deberías — y en la entrega lo será. La diferencia es el rol: una contratación interna mantiene el sistema día a día; a mí me traen para diseñarlo una vez, con el patrón de muchos de estos builds ya incorporado — la batería de evaluación, los modos de falla, la compuerta. Las horas de build son la parte barata. El costo real de hacerlo internamente es el continuo: mantener las evaluaciones honestas, perseguir el desvío de modelos y APIs, y la regresión que nadie atrapa hasta que lo hace un cliente. Yo lo levanto para que aguante, y luego le entrego las llaves a tu equipo.
Después de la entrega — ¿qué pasa si se rompe, y qué pasa si no estás disponible?
Todo queda en tu repositorio y CI, con un runbook y una guía — sin dependencia de mí, nada atado a mi plataforma. Si algo se desvía, la compuerta está construida para atraparlo antes de que se lance y el runbook dice exactamente qué hacer. El acceso, las credenciales y un plan de entrega por escrito existen desde el día uno, de modo que el trabajo sobrevive a que yo no esté disponible. La ventana opcional de operación está ahí si quieres una mano, no porque vayas a necesitarla.
¿Y si las evaluaciones muestran que nuestra función de IA está bien?
Entonces lanzas con evidencia en lugar de esperanza. Esa es la victoria. La suite permanece en CI atrapando la regresión que habría aparecido dentro de seis semanas.
¿Puestos de tiempo completo?
Abierto al adecuado. El interruptor "Contrátame" de arriba reencuadra esta página para reclutadores, y el PDF del currículum está a un clic.
05
05 — acerca de
JTJason Teixeira
Durante trece años mi trabajo fue asegurar que el software realmente funcionara. El tipo de QA donde un bug que se escapa cuesta dinero real. Luego las funciones de IA empezaron a lanzarse con un demo y un rezo, y vi buenos productos romperse de formas que un cliente descubría primero. Así que ahora construyo ambas mitades: la IA, y la prueba de que funciona.
— Jason Teixeira · fundador, Sage Ideas
Dirijo Sage Ideas, un estudio nativo de IA, y he pasado años construyendo lo mismo en cada capa: sistemas que se niegan a decir "listo" sin evidencia.
Esa tesis aparece como un SO de ingeniería con un libro de pruebas encadenado por hash, una plataforma de QA donde cada puntaje se calcula a partir de un comando real, y pipelines de agentes con evaluaciones de trazas doradas conectadas a CI. El patrón siempre es el mismo: lanzar la función, luego lanzar la maquinaria que la atrapa cuando presenta una regresión.
Si tu equipo lanza funciones de LLM por intuición (sin suite de evaluación, sin compuerta de regresión, sin idea de si el cambio de prompt de la semana pasada empeoró las cosas), esa es exactamente la brecha que cierro.
Yo construyo
LangGraph · agentes Mastra
RAG — pgvector · citas
flujos n8n · Make · Zapier
Next.js · FastAPI · Supabase
agentes de voz — Retell · Vapi
JTun ingeniero
Yo pruebo
Playwright · Pytest · k6
Promptfoo · DeepEval
LLM-as-judge — fidelidad
jailbreak · inyección · evals de PII
compuertas de CI · evidencia firmada
capacidad
constructor de IA típico
ingeniero de QA típico
yo
Lanza funciones de LLM (RAG, agentes, automatización)
✓
—
✓
Construye suites de evaluación & compuertas LLM-as-judge
raro
raro
✓ lanzado
Disciplina de regresión en CI (Playwright/Pytest)
—
✓
✓ 13 años
Batería de seguridad IA (inyección · PII · toxicidad)
—
—
✓ 10 runners
Evidencia que puedes auditar (firmada, reproducible)
—
raro
✓ por diseño
Certificado para ello (ISTQB CT-AI + TAE)
—
raro
✓ ambas
06
06 — trayectoria
Rigor de Fortune 50, velocidad de fundador.
Trece años en retail empresarial y fintech, más un estudio nativo de IA. Cada rol en la misma disciplina: automatización que prueba que el software funciona. Las cifras de roles anteriores son autoreportadas. Currículum completo (PDF) ↓ · Resumen de la empresa · Mira la prueba →
Sage Ideas · Nexural
Fundador, Ingeniero de Automatización con IA & QA2024 — presente · Orlando, FL / remoto
Construí todo lo del índice de arriba: el almacén de agentes, el SO de ingeniería proof-first, y una plataforma de QA de 85 runners con diez evaluaciones dedicadas a la seguridad de LLM.
Nexural Research: 58 endpoints FastAPI · 604 pruebas · 93% cobertura, validación de respuestas de IA que contrasta las afirmaciones del modelo con métricas deterministas de la fuente.
Infraestructura de pruebas basada en Kubernetes que ejecuta 500+ pruebas contra flujos de trading en vivo (volumen diario de $100k+); tasa de flaky reducida de 10% → <1% con reintento inteligente.
Ejecución de pruebas de 45 min → 8 min (−82%) mediante contenerización con Docker y ejecuciones paralelas entre microservicios.
ejecución de pruebas45m → 8m
The Home Depot
Tester de Software → Ingeniero de Automatización → Ingeniero de Nube2012 — 2021 · Fortune 50
Framework de Selenium + Python para sistemas que dan servicio a 2,300+ tiendas: regresión 4 h → 75 min (−70%), 300+ casos automatizados con 99.5% de estabilidad.
Lideré la migración empresarial a AWS (Terraform, Kubernetes): −35% de costo de infraestructura, despliegues de 4 h → 15 min mediante pipelines de Jenkins/GitLab.
regresión4h → 75m
despliegues4h → 15m
credenciales
ISTQB CT-AI — pruebas de IAISTQB Test Automation EngineerISTQB CTFLAWS Cloud PractitionerAWS ML FoundationsTripleTen Automatización con IA
Lic. en Ciencias de la Computación, Full Sail · Lic. en Finanzas, Kean · Inglés + Portugués nativo · Español profesional
07 — en números
13+
años en calidad & automatización
140
repos públicos en GitHub
85
runners de calidad construidos
78
compuertas de release, todas en verde
08
08 — notas de campo
Notas de trabajo desde las trincheras del proof-first.
15 minutos. Trae la función que te da miedo. Vete con un plan concreto de evaluación y automatización.
Una contratación, dos disciplinas.
El ingeniero que lanza la función de LLM y el arnés que la protege. Hablemos de tu equipo.
elige un horario — 15 min, gratis·Yo mismo atiendo la llamada y respondo. Sin equipo de ventas, sin spam — una confirmación instantánea, luego una respuesta real de mi parte.
✓Cada proyecto se cotiza por escrito antes de empezar: alcance fijo, nunca horas abiertas. La tarifa de la auditoría se abona directamente al build si continúas. Si la definición de alcance muestra que no puedo ayudar, lo diré y no cuesta nada.
un proyecto a la vez — actualmente agendando Q4 2026
mini-evaluación gratis · una muestra de trabajo que se queda
Envíame tu función de IA. Ejecutaré una mini-evaluación gratis sobre ella y te enviaré los hallazgos: aprobado/reprobado, ejemplos de fallo, y qué pondría tras una compuerta antes de tu próximo release. Sin llamada requerida.
1 — llamada de introducción
15 minutos, gratis. Trae la función que te da miedo.
2 — mapa de riesgos
Semana 1: acordamos qué significa "que funcione" y cómo se mide.
3 — cotización fija
Precio atado a entregables en lugar de horas abiertas. En cualquier caso, el plan es tuyo.